


Focos
Ingeniero de aprendizaje automático, ingeniero de sistemas de aprendizaje automático, ingeniero de aprendizaje automático aplicado, ingeniero de MLOps, ingeniero de IA, ingeniero de plataformas de aprendizaje automático, ingeniero de infraestructura de aprendizaje automático, ingeniero de aprendizaje automático en producción, ingeniero de software de aprendizaje automático, ingeniero de IA aplicada, ingeniero de operaciones de aprendizaje automático, ingeniero de implementación de aprendizaje automático
Cada vez que tu móvil termina una frase por ti, tu aplicación de streaming te sugiere la serie perfecta para ver a continuación, tu banco bloquea una tarjeta robada en tiempo real o una aplicación de fotos encuentra todas las fotos de tu perro sin que tengas que buscarlas, hay un modelo de aprendizaje automático trabajando entre bastidores. Alguien tuvo que sacar ese modelo de un cuaderno de investigación y convertirlo en un sistema que funciona a la perfección, para millones de personas, cada segundo de cada día. Esa persona es un ingeniero de aprendizaje automático.
Los ingenieros de aprendizaje automático crean, implementan y mantienen los flujos de trabajo y los sistemas que permiten que los modelos de aprendizaje automático funcionen en el mundo real, y no solo en un entorno experimental. Toman un modelo que un científico de datos o un investigador ha entrenado en un ordenador portátil y lo reconvierten en algo capaz de gestionar enormes cantidades de tráfico en tiempo real, seguir funcionando cuando un servidor falla y reentrenarse de forma automática a medida que llegan nuevos datos. En este proceso, colaboran estrechamente con científicos de datos, ingenieros de software, gestores de producto e ingenieros de datos para garantizar que el sistema satisfaga las necesidades reales de la empresa y de sus usuarios.
Mediante herramientas como Python, PyTorch o TensorFlow, Docker, Kubernetes y plataformas en la nube como AWS, Azure o Google Cloud, los ingenieros de aprendizaje automático convierten prototipos frágiles en una infraestructura fiable. Crean flujos de trabajo automatizados que prueban e implementan nuevas versiones de modelos, paneles de control que detectan problemas antes de que los usuarios se den cuenta y sistemas que reentrenan los modelos a medida que cambia el mundo. Sin esta ingeniería entre bastidores, incluso el modelo más inteligente se quedaría relegado a un artículo de investigación en lugar de impulsar los productos en los que la gente confía cada día.
- Ver cómo un modelo que has creado pasa de ser una idea de investigación a convertirse en un sistema que utilizan millones de personas reales
- Resolver complejos retos de ingeniería relacionados con la velocidad, la fiabilidad y la escala que ningún libro de texto aborda en su totalidad
- Trabajar en la apasionante intersección entre la ingeniería de software, la ciencia de datos y el diseño de productos
- Ver cómo tu trabajo influye directamente en un indicador real, como detectar más casos de fraude u ofrecer mejores recomendaciones a los usuarios
Horario de trabajo
La mayoría de los ingenieros de aprendizaje automático trabajan a tiempo completo, normalmente unas 40 horas a la semana, aunque los lanzamientos, las interrupciones del servicio o los errores urgentes pueden alargar la jornada o requerir estar de guardia. El trabajo suele consistir en una combinación de escribir código en el escritorio, revisar paneles de control y métricas, y reunirse con científicos de datos e ingenieros para planificar funcionalidades o solucionar problemas. La mayoría trabaja para empresas tecnológicas, startups o las divisiones tecnológicas de grandes empresas de los sectores financiero, minorista, sanitario y otros, aunque algunos trabajan como consultores o contratistas en proyectos específicos.
Funciones típicas
- Crear y mantener flujos de datos que alimenten los modelos durante el entrenamiento y en producción
- Entrenamiento, evaluación y ajuste de modelos de aprendizaje automático en función de una métrica empresarial objetivo
- Empaquetar modelos en contenedores e implementarlos en servidores o en la nube
- Creación de API y servicios que permiten a las aplicaciones y otros sistemas consultar un modelo en tiempo real
- Configuración de flujos de trabajo automatizados que prueban e implementan nuevas versiones de modelos de forma segura
- Supervisión de modelos en tiempo real para detectar desviaciones en la precisión, tiempos de respuesta lentos y fallos inesperados
- Reentrenar los modelos con datos nuevos para que las predicciones sigan siendo precisas con el paso del tiempo
- Optimizar los modelos para que funcionen más rápido y resulten más económicos mediante técnicas como la cuantificación y el procesamiento por lotes
- Colaborar con científicos de datos para convertir los prototipos de investigación en sistemas listos para su implementación
- Gestión de la infraestructura en la nube, el almacenamiento y los recursos informáticos, como las GPU
- Redacción de pruebas automatizadas, revisiones de código y documentación técnica
- Resolución de problemas de producción cuando un modelo se comporta de forma inesperada
Responsabilidades adicionales
- Prever los costes informáticos y encontrar formas de gestionar los sistemas de manera más eficiente
- Gestión de versiones de conjuntos de datos y modelos para que los resultados siempre puedan reproducirse
- Apoyo al cumplimiento de las normas de privacidad y seguridad de los datos en los sistemas que utilizan datos personales
- Orientar a los ingenieros y científicos de datos noveles sobre las mejores prácticas en entornos de producción
- Evaluar nuevas herramientas y marcos de trabajo a medida que evoluciona el sector
- Participar en turnos de guardia para hacer frente a las interrupciones del sistema
- Comunicar con claridad las compensaciones técnicas a las partes interesadas del producto y del negocio
El día a día de un ingeniero de aprendizaje automático suele empezar revisando los paneles de control de la noche anterior, para asegurarse de que los modelos siguen ofreciendo predicciones precisas y rápidas, y de que ningún proceso ha fallado mientras nadie estaba pendiente. Si algo parece fuera de lo normal, la primera hora puede convertirse en una sesión de depuración, en la que hay que rastrear el origen del problema a través de los registros, los procesos de datos y el código del modelo.
Normalmente, la hora del mediodía la dedico a desarrollar. Eso puede significar escribir código para reentrenar un modelo con nuevos datos, mejorar una API que proporciona predicciones a una aplicación o trabajar con un científico de datos para averiguar por qué un modelo prometedor rinde peor cuando se enfrenta al tráfico real. Suele haber reuniones intercaladas, en las que me coordino con los jefes de producto sobre lo que el modelo debe hacer de forma diferente, o con los ingenieros de datos sobre un cambio en una fuente de datos previa.
Las tardes suelen dedicarse a las pruebas y a los envíos. El ingeniero puede ejecutar una nueva versión del modelo a través de un proceso automatizado, observar cómo se implementa en un pequeño grupo de usuarios y comparar su rendimiento con el de la versión anterior antes de lanzarla de forma más generalizada. Antes de dar por terminada la jornada, documenta los cambios realizados, actualiza los tickets y comprueba que el sistema de monitorización funciona correctamente, de modo que los paneles de control de mañana detecten cualquier anomalía.
Habilidades sociales
- Pensamiento analítico y lógico
- Comunicación técnica clara, especialmente con compañeros de equipo sin formación técnica
- Paciencia a la hora de depurar sistemas con muchos componentes en movimiento
- Colaboración entre los equipos de ciencia de datos, ingeniería y producto
- Atención al detalle, ya que los pequeños errores pueden provocar grandes fallos a gran escala
- Gestión del tiempo en varios proyectos en curso
- Capacidad para lidiar con la ambigüedad y resolver problemas de forma iterativa
- Capacidad de adaptación ante los rápidos cambios en las herramientas, los modelos y las prioridades
- Responsabilidad y rendición de cuentas respecto a los sistemas una vez que están en funcionamiento
- Curiosidad por seguir aprendiendo nuevos marcos de trabajo y técnicas
- Toma de decisiones con serenidad ante incidencias durante la producción
- Disposición a dar y recibir comentarios directos en las revisiones de código
Habilidades técnicas
- Programación en Python para el procesamiento de datos, la modelización y la automatización
- Marcos de aprendizaje automático como PyTorch, TensorFlow o scikit-learn
- Herramientas de SQL y de canalización de datos para trasladar y transformar grandes conjuntos de datos
- Docker y Kubernetes para empaquetar y ejecutar aplicaciones de forma fiable
- Plataformas en la nube como AWS, Google Cloud o Microsoft Azure
- Herramientas de CI/CD para pruebas y despliegues automatizados
- Git y los flujos de trabajo de desarrollo colaborativo de software
- Herramientas de computación distribuida, como Spark, para el procesamiento de datos a gran escala
- Herramientas de monitorización y seguimiento de experimentos como MLflow, Prometheus o Weights & Biases
- Diseño y mantenimiento de API REST y microservicios
- Ingeniero de aprendizaje automático de plataforma: se encarga de desarrollar la infraestructura y las herramientas compartidas que utilizan otros equipos para entrenar e implementar modelos
- Ingeniero de aprendizaje automático aplicado: se centra en desarrollar y poner en producción modelos para una funcionalidad específica del producto
- Ingeniero de MLOps: especializado en automatización, supervisión y fiabilidad de los sistemas de aprendizaje automático en producción
- Ingeniero de sistemas de recomendación: se encarga de desarrollar los modelos que sugieren contenidos, productos o conexiones
- Ingeniero de aprendizaje automático especializado en fraude y riesgos: desarrolla modelos en tiempo real que detectan actividades sospechosas o fraudulentas
- Ingeniero de búsqueda y posicionamiento: crea modelos que determinan qué resultados aparecen en primer lugar y por qué
- Ingeniero de aprendizaje automático en el borde y en sistemas embebidos: optimiza modelos para que se ejecuten directamente en teléfonos, sensores u otros dispositivos
- Empresas tecnológicas y startups de software
- Empresas de comercio electrónico y minoristas
- Empresas de servicios financieros y de tecnología financiera
- Empresas del sector sanitario y de la biotecnología
- Empresas de streaming, medios de comunicación y entretenimiento
- Redes sociales y plataformas de comunicación
- Proveedores de servicios de computación en la nube y de infraestructura
- Empresas de vehículos autónomos y robótica
- Organismos gubernamentales y equipos tecnológicos del sector público
- Empresas de consultoría y servicios tecnológicos
- Empresas del sector de la fabricación y la logística que utilizan el análisis predictivo
- Laboratorios de investigación y departamentos de IA aplicada de grandes empresas
Se espera que los ingenieros de aprendizaje automático desarrollen sistemas que funcionen no solo una vez, sino siempre, en condiciones reales que son mucho más complejas que cualquier conjunto de datos de prueba. Cuando un modelo falla de forma silenciosa, puede suponer una pérdida de ingresos, una decisión injusta o una experiencia de usuario deficiente, por lo que la presión para detectar los problemas a tiempo es constante. Estar de guardia para los sistemas de producción significa que las interrupciones del servicio no esperan al horario laboral, y un incidente grave puede suponer pasar la noche en vela o un fin de semana depurando el sistema.
El ritmo en este ámbito es trepidante. Constantemente surgen nuevos marcos de trabajo, arquitecturas de modelos y buenas prácticas, y los ingenieros que dejan de formarse se quedan rápidamente rezagados. Encontrar el equilibrio entre el entusiasmo por las nuevas técnicas y la disciplina necesaria para mantener los sistemas existentes estables y bien documentados supone una tensión constante.
También existe una brecha entre la idea glamurosa de «desarrollar IA» y la realidad cotidiana de programar flujos de trabajo, corregir datos erróneos y supervisar paneles de control. Gran parte del trabajo consiste en tareas de fondo poco glamurosas que hacen posible que existan las partes emocionantes, y los ingenieros que destacan en este ámbito encuentran una verdadera satisfacción en esa fiabilidad invisible.
- El crecimiento de LLMOps: la aplicación de la disciplina de MLOps a las aplicaciones de modelos de lenguaje a gran escala
- Un uso más generalizado de los almacenes de características para compartir y reutilizar características de datos entre equipos
- Adopción de bases de datos vectoriales para potenciar las funciones de IA basadas en la búsqueda y la recuperación
- Apostar por la inferencia en tiempo real y en streaming en lugar de las predicciones por lotes
- Expansión de la IA en el borde, con la ejecución de modelos directamente en teléfonos y dispositivos
- Aumentar la automatización de los procesos de reentrenamiento para mantener los modelos actualizados sin necesidad de intervención manual
- Mayor atención a la IA responsable, incluida la supervisión de los sesgos y la equidad en la producción
- Aumenta el interés por la optimización de costes, ya que la ejecución de modelos a gran escala resulta costosa
- El auge de las plataformas «low-code» y de aprendizaje automático gestionado, que reducen las barreras de implementación
- Ampliación de equipos híbridos que combinan la ingeniería de software tradicional con conocimientos especializados en aprendizaje automático
Muchos ingenieros de aprendizaje automático crecieron disfrutando tanto de construir cosas como de averiguar por qué se estropeaban. Les gustaba programar pequeños proyectos, modificar videojuegos o automatizar tareas repetitivas y pesadas con un script en lugar de hacerlas a mano. Las clases de matemáticas e informática les resultaban interesantes no por las notas, sino porque les gustaba ver cómo una idea se convertía en algo que realmente funcionaba.
A otros les atraían los rompecabezas, los juegos de estrategia y las competiciones como las olimpiadas matemáticas o los hackatones, donde la diversión residía tanto en la depuración y la iteración como en la respuesta final. La costumbre de trastear, ya fuera con un kit de robótica, una página web personal o un servidor doméstico, solía traducirse directamente en una carrera profesional dedicada a crear y mantener sistemas reales.
La mayoría de los ingenieros de aprendizaje automático cuentan con una licenciatura en informática, ingeniería de software, ciencia de datos o un campo estrechamente relacionado, y un número cada vez mayor cursa un máster para acceder a puestos más avanzados. Lo que más valoran las empresas es una base sólida en ingeniería de software combinada con habilidades prácticas en aprendizaje automático, por lo que muchos ingenieros complementan su formación académica con cursos en línea, certificaciones y proyectos personales.
Los estudiantes pueden cursar asignaturas relacionadas con temas como:
- Estructuras de datos y algoritmos
- Programación en Python
- Estadística y Probabilidad
- Álgebra lineal
- Bases de datos y SQL
- Aprendizaje automático
- Sistemas distribuidos
- Computación en la nube
- Prácticas de ingeniería de software
- Redes informáticas
En este campo, la experiencia práctica es tan importante como los estudios. Las prácticas, los proyectos personales implementados en la nube y las contribuciones a herramientas de aprendizaje automático de código abierto proporcionan a los estudiantes una prueba real de que son capaces de crear sistemas que funcionan, y no solo de aprobar exámenes. Muchos ingenieros también crean un portafolio en plataformas como GitHub y Kaggle para demostrar sus habilidades prácticas a futuros empleadores.
- Cursa asignaturas de matemáticas, incluyendo cálculo y estadística, ya que son la base del aprendizaje automático
- Aprende a programar en Python a través de cursos en línea, clubes o proyectos propios
- Apúntate a un club de programación, a un equipo de robótica o a un concurso de informática
- Crea pequeños proyectos personales y publica el código en GitHub
- Apúntate a un curso gratuito en línea sobre aprendizaje automático para ver si este campo te interesa.
- Participa en hackatones o en concursos de Kaggle para practicar cómo crear y lanzar proyectos
- Aprende los conceptos básicos de la computación en la nube implementando un proyecto sencillo en una cuenta de nube con plan gratuito
- Estudia los fundamentos de la informática, como las estructuras de datos y los algoritmos
- Practica cómo redactar de forma clara sobre proyectos técnicos para un currículum o un portafolio
- Busca prácticas o trabajos a tiempo parcial relacionados con el desarrollo de software o el tratamiento de datos
- Habla con ingenieros en activo sobre cómo es realmente su día a día en el trabajo.
- Colabora en un proyecto de código abierto para practicar la colaboración en el mundo real
- Un sólido plan de estudios básico de informática, no solo teoría del aprendizaje automático
- Cursos que incluyen proyectos prácticos en los que se implementan sistemas reales y operativos
- Acceso a recursos de computación en la nube y a hardware moderno con GPU para los trabajos del curso
- Profesores o formadores con experiencia profesional en sistemas de producción
- Apoyo para la búsqueda de prácticas en empresas tecnológicas
- Un proyecto de fin de carrera en el que se desarrolla y se pone en marcha un sistema integral
- Tratamiento de prácticas de ingeniería de software como las pruebas, el control de versiones y la revisión de código
- Oportunidades para trabajar con conjuntos de datos reales, en lugar de limitarse únicamente a ejemplos simplificados de los libros de texto
- Servicios de orientación profesional con estrechos vínculos con empresas del sector tecnológico
- Opciones flexibles para seguir formándose a través de cursos y certificaciones en línea tras la graduación
- Una comunidad de compañeros que trabajan en proyectos similares, como un club de aprendizaje automático
- Un plan de estudios actualizado que se adapta a un ámbito en constante evolución
- Crea un portafolio de proyectos implementados, no solo de cuadernos que nunca han salido de tu ordenador portátil.
- Solicita puestos de nivel inicial, como ingeniero junior de aprendizaje automático, ingeniero de datos o ingeniero de software especializado en aprendizaje automático.
- Colabora en proyectos de aprendizaje automático de código abierto para crear un historial público
- Participa en los concursos de Kaggle y documenta tu método y tus resultados
- Practica cómo explicar tus proyectos con claridad, incluyendo qué falló y cómo lo solucionaste.
- Establece contactos con ingenieros y responsables de selección de personal en encuentros, conferencias y comunidades online
- Busca en las bolsas de empleo y en las páginas de empleo de las empresas, y configura alertas para puestos relevantes.
- Plantéate realizar prácticas o programas de formación en alternancia, que a menudo se convierten en ofertas de trabajo a tiempo completo
- Aprende a implementar un proyecto de principio a fin en una plataforma en la nube antes de tu primera entrevista
- Prepárate para entrevistas técnicas sobre programación, diseño de sistemas y conceptos básicos de aprendizaje automático
- Destaca cualquier experiencia con sistemas de producción, incluso si se trata de proyectos escolares o personales.
- Muéstrate dispuesto a empezar como ingeniero de datos o ingeniero de backend para adquirir experiencia relevante
- A medida que adquieras experiencia, ve asumiendo la responsabilidad de sistemas más grandes y críticos.
- Aprende a diseñar sistemas desde cero, no te limites a poner en práctica el plan de otra persona
- Crear un historial de sistemas fiables y bien supervisados que rara vez fallan
- Orientar a los ingenieros más noveles y revisar su código y sus diseños
- Adquiere conocimientos especializados en un ámbito concreto, como MLOps, los sistemas de recomendación o la infraestructura
- Contribuir a las decisiones de arquitectura y a la estrategia técnica entre equipos
- Realiza cursos avanzados, obtén certificaciones o cursa un máster si ello se ajusta a tus objetivos
- Accede a puestos de ingeniero sénior, ingeniero de plantilla o de dirección de ingeniería
Sitios web:
- Artículos con código - paperswithcode.com
- Hugging Face - huggingface.co
- Kaggle - kaggle.com
- Documentación de MLflow - mlflow.org
- Creado con ML - madewithml.com
- Full Stack Deep Learning - fullstackdeeplearning.com
- DeepLearning.AI - deeplearning.ai
- Hacia la ciencia de datos - towardsdatascience.com
- NeurIPS - neurips.cc
- Blog de IA de Google - ai.googleblog.com
- GitHub - github.com
- El blog de Chip Huyen - huyenchip.com
Libros:
- «Diseño de sistemas de aprendizaje automático», de Chip Huyen
- Ingeniería de aprendizaje automático, de Andriy Burkov
- «Creación de aplicaciones basadas en el aprendizaje automático», de Emmanuel Ameisen
- «Aprendizaje automático fiable», de Cathy Chen, Niall Richard Murphy, Kranti Parisa, D. Sculley y Todd Underwood
- «Deep Learning», de Ian Goodfellow, Yoshua Bengio y Aaron Courville
Si descubres que la profesión de ingeniero de aprendizaje automático no es lo tuyo, tus habilidades en programación, pensamiento sistémico y gestión de datos te serán de gran utilidad en muchas otras profesiones relacionadas.
- Ingeniero de datos
- Ingeniero de software
- Científico de datos
- Ingeniero de DevOps
- Analista de datos
- Ingeniero de backend
- Arquitecto de soluciones en la nube
- Ingeniero de control de calidad y automatización de pruebas
- Analista de inteligencia empresarial
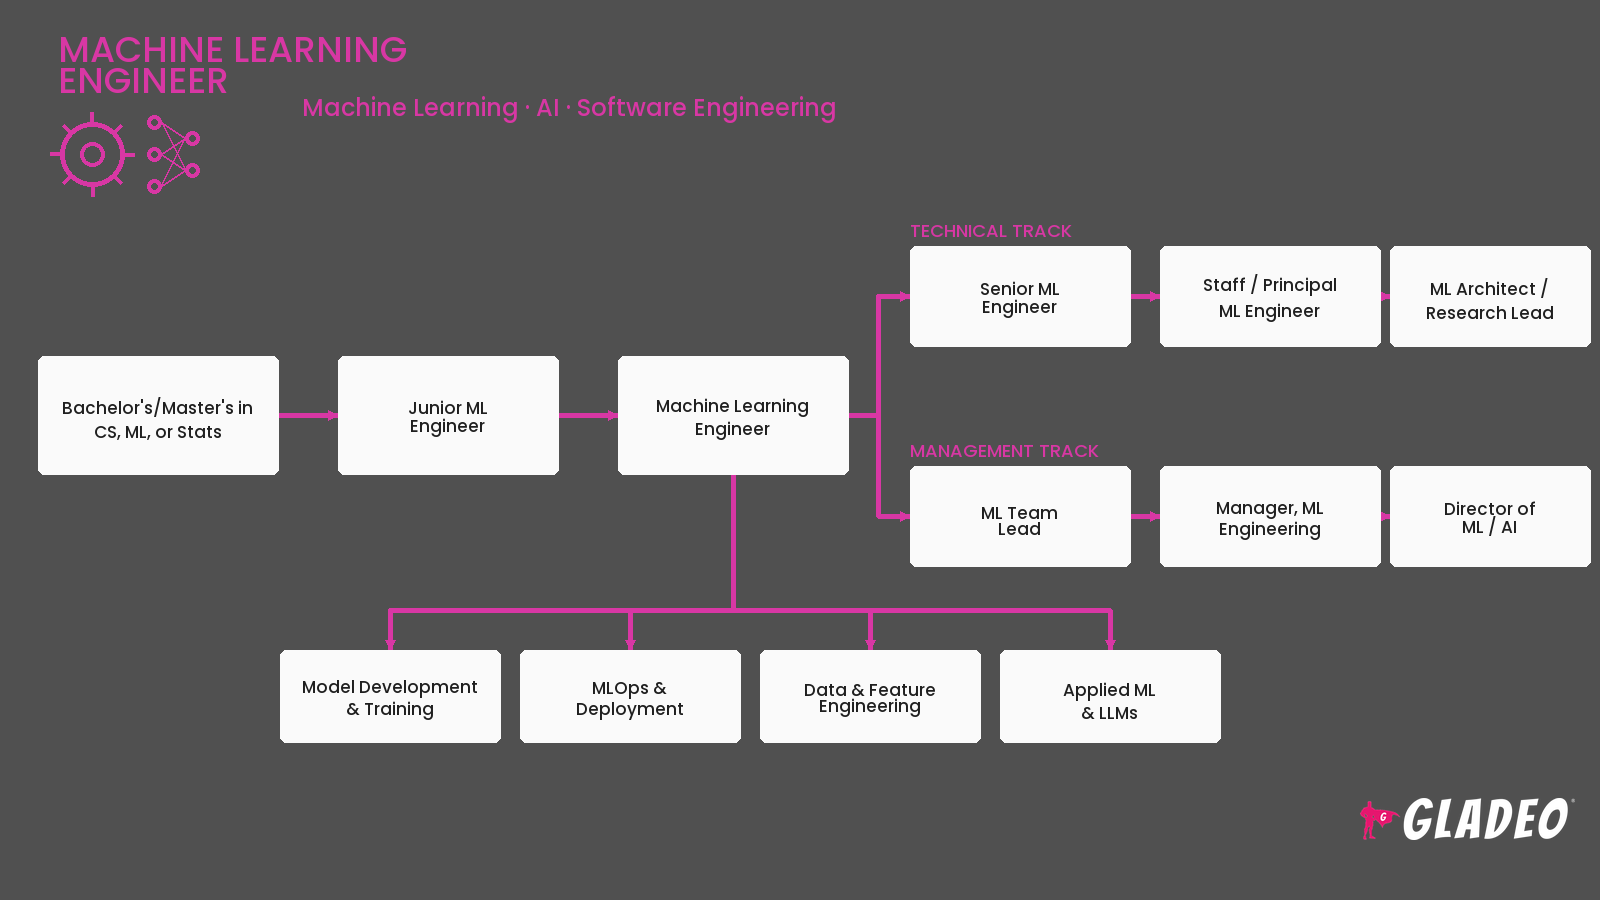
Haga clic aquí para descargar la infografía.
Fuente de noticias
Empleos destacados
Cursos y herramientas en línea