


Focos
Investigador en aprendizaje profundo, ingeniero de redes neuronales, ingeniero de entrenamiento distribuido, científico en aprendizaje profundo, arquitecto de modelos de IA, ingeniero de entrenamiento a gran escala, ingeniero de investigación en aprendizaje profundo, ingeniero de computación en GPU, ingeniero de arquitectura neuronal, científico en aprendizaje profundo aplicado
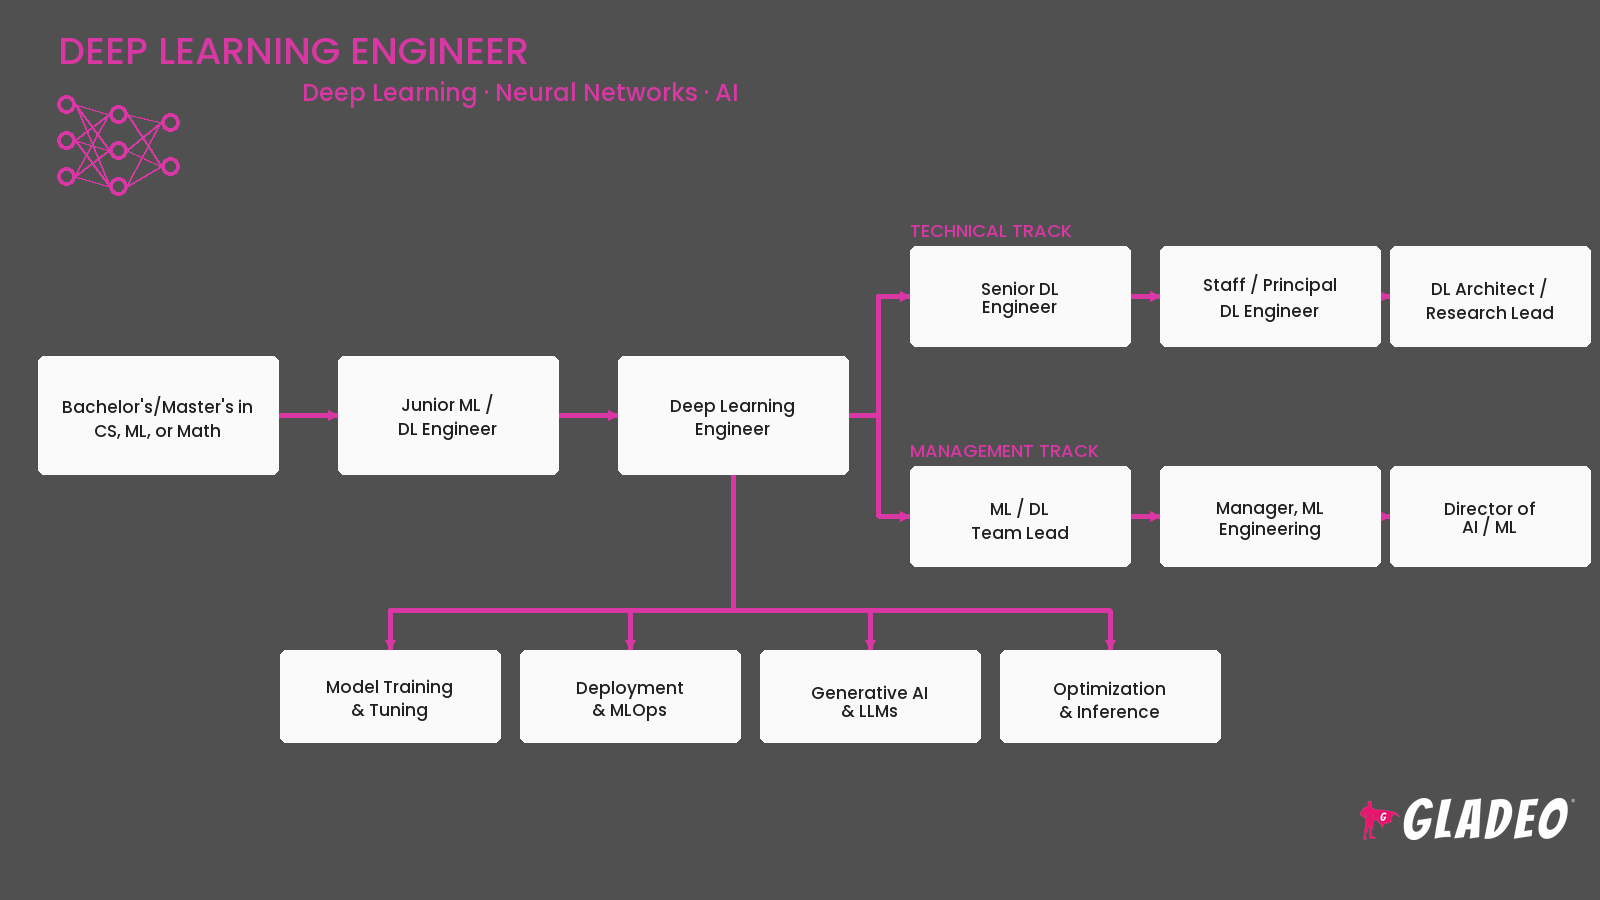
Los modelos que hay detrás de los generadores de imágenes que crean arte a partir de una frase, los chatbots que mantienen conversaciones reales, los sistemas que predicen cómo se pliegan las proteínas y los coches que reconocen la carretera que tienen delante tienen algo en común: enormes redes neuronales entrenadas en racks de GPU que funcionan durante días o semanas seguidas. Diseñar esas redes y controlar ese proceso de entrenamiento, para que realmente se complete y funcione, es el trabajo del ingeniero de aprendizaje profundo.
Los ingenieros de aprendizaje profundo se centran en la arquitectura y el entrenamiento de redes neuronales a gran escala, un enfoque distinto al de los ingenieros que implementan modelos ya terminados en los productos. Diseñan y crean prototipos de nuevas estructuras de red, ejecutan tareas de entrenamiento distribuidas entre docenas o cientos de GPU y depuran problemas que solo surgen a gran escala, como una sesión de entrenamiento que se bloquea misteriosamente o un valor de pérdida que se dispara de repente. Trabajan en estrecha colaboración con los investigadores que conciben nuevas ideas, los ingenieros de infraestructura que gestionan el hardware y los equipos de hardware que optimizan los chips en los que se ejecuta todo.
Mediante el uso de marcos como PyTorch, TensorFlow o JAX, la programación de GPU con CUDA y herramientas de entrenamiento distribuido como DeepSpeed, Megatron-LM y Ray, los ingenieros de aprendizaje profundo convierten una idea prometedora en un modelo que realmente se entrena con éxito y de forma eficiente. Su trabajo determina si los modelos de IA más ambiciosos son siquiera posibles y si su entrenamiento supone un coste razonable o una fortuna desmesurada, lo que los convierte en piezas clave para casi todos los avances importantes en la IA moderna.
- Trabajar en la vanguardia tecnológica que hace posible el desarrollo de los modelos de IA más grandes y potentes
- Resolver retos de ingeniería complejos que combinan conocimientos de matemáticas, sistemas y hardware
- Ser de los primeros en ver cómo una arquitectura totalmente nueva funciona realmente a gran escala
- Contribuir directamente a los avances que marcarán el rumbo de la tecnología en los próximos años
Horario de trabajo
La mayoría de los ingenieros de aprendizaje profundo trabajan a tiempo completo, aunque el horario suele adaptarse a los procesos de entrenamiento de larga duración que deben supervisarse, a veces durante la noche o el fin de semana, ya que un proceso de entrenamiento de varias semanas no puede simplemente pausarse y reanudarse cuando convenga. El trabajo se realiza en gran medida por ordenador y se divide entre escribir y revisar código, analizar registros y métricas de entrenamiento, y colaborar con equipos de investigación e infraestructura. La mayoría de los ingenieros de aprendizaje profundo trabajan en laboratorios de investigación en IA, grandes empresas tecnológicas o startups bien financiadas que desarrollan modelos de vanguardia, ya que este trabajo requiere importantes recursos informáticos.
Funciones típicas
- Diseño y creación de prototipos de nuevas arquitecturas de redes neuronales
- Ejecución y supervisión de trabajos de entrenamiento distribuidos a gran escala en numerosas GPU o TPU
- Solucionar problemas de inestabilidad en el entrenamiento, como picos de pérdida, gradientes que desaparecen o se disparan, y fallos de hardware
- Optimización del código del modelo para mejorar la velocidad y la eficiencia en el uso de la memoria
- Aplicación de técnicas como el entrenamiento con precisión mixta y el «gradient checkpointing»
- Evaluación comparativa de nuevas arquitecturas con respecto a los puntos de referencia existentes
- Ajuste de hiperparámetros a gran escala en sesiones de entrenamiento prolongadas
- Colaboración con ingenieros de hardware e infraestructura en materia de eficiencia computacional
- Leer y poner en práctica las técnicas descritas en artículos de investigación publicados recientemente
- Creación de herramientas y scripts internos para agilizar la experimentación
- Documentar los resultados de los experimentos y compartir las conclusiones con los equipos de investigación
Responsabilidades adicionales
- Gestión y previsión de los presupuestos de recursos de cálculo en múltiples sesiones de entrenamiento
- Orientación a ingenieros noveles y becarios de investigación sobre técnicas de formación
- Contribuir al desarrollo de marcos y herramientas internas de aprendizaje profundo
- Mantenerse al día en un campo de investigación en el que se publican nuevos resultados casi cada semana
- Participar en revisiones de código y arquitectura
- Publicar ocasionalmente los resultados en informes internos o artículos externos
La jornada de un ingeniero de aprendizaje profundo suele comenzar revisando los trabajos de entrenamiento que se han ejecutado durante la noche, analizando las curvas de pérdida y las métricas para comprobar si una ejecución avanza con normalidad o si ha surgido algún contratiempo, como un proceso bloqueado o un pico de errores. Si algo parece ir mal, las primeras horas pueden convertirse en una sesión intensiva de depuración del código, los datos y los registros de hardware.
Por lo general, dedicamos el mediodía a desarrollar y experimentar, ya sea implementando una nueva idea arquitectónica, ajustando un script de entrenamiento para aprovechar mejor la GPU o resolviendo un error sutil que solo aparece cuando el entrenamiento se distribuye entre muchas máquinas. A menudo mantenemos conversaciones con los investigadores científicos sobre lo que podría significar un nuevo resultado, o con los ingenieros de infraestructura sobre cómo sacar más rendimiento a un hardware limitado.
Las tardes suelen dedicarse a poner en marcha nuevos experimentos, revisar los resultados de las ejecuciones anteriores y actualizar la documentación para que todo el equipo pueda aprender de lo que ha funcionado y de lo que no. Dado que las ejecuciones de entrenamiento pueden durar días, gran parte del trabajo consiste en planificar con inteligencia los siguientes pasos y, a continuación, analizar con paciencia y detenimiento los resultados obtenidos, en lugar de esperar respuestas inmediatas.
Habilidades sociales
- Un gran interés por saber cómo y por qué aprenden las redes neuronales
- Capacidad para aceptar la ambigüedad y la experimentación constante
- La capacidad de recuperación cuando los experimentos fracasan, algo que ocurre a menudo en este campo
- Gran capacidad de razonamiento analítico y matemático
- Paciencia durante las largas sesiones de entrenamiento que duran varios días
- Una estrecha colaboración con los equipos de infraestructuras e investigación
- Redacción técnica clara para documentar experimentos y resultados
- Atención al detalle en el código que se ejecuta a gran escala
- Perseverancia a lo largo de repetidas rondas de depuración
- Capacidad de adaptación a nuevos marcos, hardware y técnicas
- Pensamiento sereno y metódico bajo presión, ya que el procesamiento informático es costoso y los errores suponen un gasto real de dinero.
Habilidades técnicas
- PyTorch, TensorFlow o JAX para crear y entrenar redes neuronales profundas
- Programación con CUDA y GPU para código en el que el rendimiento es fundamental
- Entornos de entrenamiento distribuido como DeepSpeed, Megatron-LM, Horovod o Ray
- Álgebra lineal y cálculo para comprender la optimización y la retropropagación
- Herramientas de computación de alto rendimiento y de programación de clústeres, como Slurm o Kubernetes
- Herramientas de análisis de rendimiento y depuración para identificar cuellos de botella
- Técnicas de entrenamiento de precisión mixta y con un uso eficiente de la memoria
- Git para el control de versiones y herramientas como Weights & Biases o MLflow para el seguimiento de experimentos
- Python y, en ocasiones, C++ para el código en el que el rendimiento es fundamental
- Estadística y probabilidad para comprender el comportamiento de los modelos y su evaluación
- Ingeniero de arquitectura de modelos: diseña y crea prototipos de nuevas estructuras de redes neuronales
- Ingeniero de formación en sistemas distribuidos: se centra en ampliar la formación de forma eficiente a numerosas máquinas
- Ingeniero de aprendizaje automático con conocimientos de hardware: optimiza modelos específicamente para GPU, TPU o chips de IA personalizados
- Ingeniero de modelos generativos: se centra en el entrenamiento de modelos que generan imágenes, texto, audio o vídeo
- Ingeniero de aprendizaje por refuerzo: Entrena modelos que aprenden mediante ensayo, error y recompensa
- Ingeniero de investigación en escalabilidad: estudia cómo varía el rendimiento de los modelos a medida que aumentan el tamaño y el volumen de datos
- Ingeniero de eficiencia y compresión: se dedica a hacer que los modelos de gran tamaño sean más pequeños, más rápidos y más económicos de ejecutar
- Laboratorios de investigación en IA y desarrolladores de modelos de vanguardia
- Grandes empresas tecnológicas con departamentos específicos dedicados a la investigación en inteligencia artificial
- Proveedores de computación en la nube que desarrollan infraestructuras y servicios de inteligencia artificial
- Startups de IA con una sólida financiación que desarrollan modelos a gran escala
- Empresas de semiconductores y hardware que fabrican chips de IA
- Empresas de vehículos autónomos y robótica
- Instituciones de investigación científica que utilizan el aprendizaje profundo para la investigación
- Organismos de investigación gubernamentales y laboratorios nacionales
- Universidades con sólidos programas de investigación en aprendizaje profundo
- Empresas de tecnología financiera que utilizan modelos predictivos a gran escala
- Empresas del sector sanitario y biotecnológico que aplican el aprendizaje profundo a la investigación
- Organizaciones del sector de la defensa y aeroespacial que investigan sistemas avanzados de inteligencia artificial
Los ingenieros de aprendizaje profundo trabajan con recursos informáticos que son a la vez escasos y costosos, por lo que un proceso de entrenamiento fallido que dure varias semanas no solo supone una pérdida de tiempo, sino también un gran gasto económico. Esa realidad genera una presión real para planificar los experimentos con cuidado y detectar los problemas lo antes posible, y los errores pueden parecer de gran importancia, algo que no ocurre en proyectos de programación a menor escala.
El trabajo suele implicar jornadas largas y, a veces, impredecibles, sobre todo cuando hay que supervisar una prueba de entrenamiento fuera del horario laboral habitual o cuando se acerca la fecha límite de lanzamiento. Esperar días para obtener resultados, solo para descubrir un error sutil que obliga a empezar de nuevo, es una parte habitual y, a veces, agotadora del trabajo.
Este campo es tremendamente competitivo y avanza a un ritmo agotador, con la aparición constante de nuevos artículos, técnicas y pruebas de referencia. Para mantenerse al día es necesario un aprendizaje casi constante, y la sensación de que «todos los demás avanzan más rápido» es un sentimiento habitual y, a veces, estresante en este ámbito de la IA.
- Las leyes de escala siguen marcando el rumbo del desarrollo de modelos cada vez más grandes
- Desarrollo de arquitecturas de «mezcla de expertos» que activan solo algunas partes de un modelo cada vez
- Una mayor adopción de técnicas eficientes de ajuste fino, como LoRA y la cuantificación
- El uso cada vez mayor de hardware especializado en IA, incluidos chips personalizados y TPU
- El uso cada vez mayor de datos sintéticos para complementar o sustituir los escasos datos de entrenamiento del mundo real
- Avances en la dispersión y la compresión de modelos para reducir los costes de entrenamiento e inferencia
- El rápido crecimiento de los modelos base multimodales entrenados conjuntamente con texto, imágenes y audio
- La tendencia al alza de las publicaciones de modelos de peso abierto está redefiniendo quién puede dedicarse a la investigación de vanguardia
- Cada vez se presta más atención al consumo energético y al coste medioambiental de los entrenamientos a gran escala
- La creciente colaboración entre los ingenieros especializados en aprendizaje profundo y los diseñadores de chips de hardware
Muchos ingenieros de aprendizaje profundo crecieron apasionados por las olimpiadas matemáticas, los retos de programación y montar o mejorar sus propios ordenadores. Les atraían los sistemas con muchas piezas móviles, ya fuera modificar un videojuego, overclockear un ordenador para juegos o escribir scripts para automatizar tareas tediosas.
Otros encontraron su pasión en las clases de física y matemáticas avanzadas, disfrutando del reto que suponían los problemas cuya resolución exigía una gran perseverancia. La fascinación tanto por la teoría que explica cómo funcionan las cosas como por los experimentos prácticos necesarios para que funcionen realmente solía traducirse directamente en una carrera dedicada a entrenar las redes neuronales más grandes del mundo.
La mayoría de los ingenieros de aprendizaje profundo cuentan, como mínimo, con una titulación universitaria en informática, matemáticas, física o ingeniería eléctrica, y muchos puestos, especialmente en laboratorios centrados en la investigación, dan preferencia a los candidatos con un máster o un doctorado. Unas sólidas bases matemáticas y la experiencia práctica en el entrenamiento de modelos reales —y no solo en el estudio de la teoría— son lo que distingue a los candidatos que tienen éxito.
Los estudiantes pueden cursar asignaturas relacionadas con temas como:
- Álgebra lineal
- Cálculo multivariable
- Probabilidad y estadística
- Aprendizaje profundo
- Computación paralela y distribuida
- Arquitectura de ordenadores
- Teoría de la optimización
- Estructuras de datos y algoritmos
- Aprendizaje automático
- Métodos numéricos
Dado que este campo requiere un gran uso de recursos informáticos, es fundamental contar con experiencia práctica en el entrenamiento de modelos reales, aunque sean pequeños, en hardware real. Realizar cursos de aprendizaje profundo de código abierto, reproducir los resultados de artículos publicados y experimentar con el entrenamiento distribuido en GPU en la nube proporciona a los estudiantes una ventaja real que un expediente académico por sí solo no puede reflejar.
- Cursa asignaturas de matemáticas, desde cálculo hasta álgebra lineal y estadística, y sigue avanzando cada vez más allá
- Aprende a programar en Python y crea pequeños proyectos con los que entrenar modelos reales
- Únete a un equipo de matemáticas, a un club de programación o a un grupo de programación competitiva
- Monta o mejora tu propio ordenador para comprender los fundamentos del hardware
- Apúntate a un curso gratuito en línea sobre aprendizaje profundo para sentar unas bases sólidas desde el principio
- Participa en hackatones o concursos relacionados con el aprendizaje automático o la inteligencia artificial
- Intenta reproducir los resultados de un artículo de investigación muy conocido a pequeña escala
- Estudia física, sobre todo temas relacionados con la optimización y los sistemas.
- Aprende los conceptos básicos de la computación en la nube entrenando un modelo en una GPU en la nube
- Lee artículos de investigación, aunque al principio solo entiendas algunas partes.
- Busca prácticas u oportunidades de investigación relacionadas con el aprendizaje automático
- Habla con ingenieros o investigadores especializados en aprendizaje profundo sobre en qué consiste realmente su trabajo
- Sólida formación en matemáticas avanzadas, especialmente en álgebra lineal y cálculo
- Acceso a hardware moderno de GPU para proyectos prácticos de aprendizaje profundo
- Profesores con experiencia activa en investigación o en el sector empresarial en el ámbito del aprendizaje profundo
- Cursos que van más allá del uso de modelos ya creados y se centran en entrenar redes desde cero
- Un proyecto final o de investigación que implique el entrenamiento y la evaluación de un modelo real
- Experiencia en informática distribuida y sistemas a gran escala, no solo en programación en una sola máquina
- Sólidos vínculos con prácticas o puestos de investigación en laboratorios de IA o empresas tecnológicas
- Oportunidades para leer y reproducir artículos de investigación como parte de las tareas del curso
- Servicios de orientación profesional o asesores especializados en carreras relacionadas con la investigación en aprendizaje profundo
- Una comunidad de investigación o un laboratorio activo al que puedas unirte mientras cursas la carrera
- Ayuda para cursar estudios de posgrado si deseas profundizar en la investigación
- Un plan de estudios actualizado que se adapta a un campo en constante evolución
- Crea un portafolio de proyectos en los que hayas entrenado modelos de verdad, y no solo hayas utilizado modelos preentrenados
- Reproduce los resultados de un artículo publicado y documenta públicamente tu proceso.
- Solicita puestos de nivel inicial como ingeniero de aprendizaje automático, ingeniero de investigación o ingeniero de aprendizaje profundo.
- Colabora en marcos de aprendizaje profundo de código abierto o en código de investigación
- Participa en concursos de aprendizaje automático que impliquen el entrenamiento de modelos reales
- Realiza prácticas de investigación en laboratorios de IA, universidades o empresas tecnológicas
- Practica cómo explicar una sesión de entrenamiento que hayas realizado, incluyendo qué salió mal y cómo lo diagnosticaste.
- Establece contactos con investigadores e ingenieros en congresos como NeurIPS o ICML
- Prepárate para entrevistas técnicas sobre matemáticas, sistemas y conceptos básicos del aprendizaje profundo
- Destaca cualquier experiencia que tengas en computación distribuida o entrenamiento a gran escala, incluso en proyectos escolares.
- Plantéate cursar un máster o un doctorado si quieres trabajar en los laboratorios más dedicados a la investigación.
- Muéstrate dispuesto a empezar en un equipo de aprendizaje automático más amplio para adquirir experiencia relevante.
- A medida que adquieras experiencia, asume la responsabilidad de proyectos de formación más amplios y ambiciosos.
- Acumular una trayectoria de éxito en el entrenamiento de modelos que cumplan objetivos de rendimiento exigentes
- Adquirir conocimientos especializados en un ámbito concreto, como los sistemas distribuidos, la eficiencia o el diseño de arquitecturas
- Orientar a los ingenieros en prácticas y a los becarios de investigación sobre técnicas de formación
- Colaborar en publicaciones, patentes o comunicados públicos de investigación
- Establecer relaciones sólidas con los equipos de infraestructura y hardware
- Mantente al día de las nuevas arquitecturas y técnicas, ya que este campo evoluciona cada semana.
- Accede a puestos de ingeniero de investigación sénior, ingeniero principal o responsable de investigación
Sitios web:
- Artículos con código - paperswithcode.com
- arXiv (cs.LG) - arxiv.org/list/cs.LG/recent
- NeurIPS - neurips.cc
- ICML - icml.cc
- Distill.pub - distill.pub
- Hugging Face - huggingface.co
- Documentación de DeepSpeed - deepspeed.ai
- Tutoriales de PyTorch - pytorch.org/tutorials
- Blog de Weights & Biases - wandb.ai/fully-connected
- Lil'Log, de Lilian Weng - lilianweng.github.io
- Blog de Google DeepMind - deepmind.google
- Full Stack Deep Learning - fullstackdeeplearning.com
Libros:
- «Deep Learning», de Ian Goodfellow, Yoshua Bengio y Aaron Courville
- «Dive into Deep Learning», de Aston Zhang, Zachary C. Lipton, Mu Li y Alexander J. Smola
- «Deep Learning para programadores con fastai y PyTorch», de Jeremy Howard y Sylvain Gugger
- «Los principios de la teoría del aprendizaje profundo», de Daniel A. Roberts y Sho Yaida
- • «Aprendizaje profundo eficiente», de Gaurav Menghani y Naresh Singh
Si descubres que la profesión de ingeniero de aprendizaje profundo no es lo tuyo, tus habilidades en matemáticas, pensamiento sistémico y programación a gran escala te serán muy útiles en muchas otras profesiones relacionadas.
- Ingeniero de aprendizaje automático
- Investigador en inteligencia artificial
- Científico de datos
- Ingeniero de computación de alto rendimiento
- Ingeniero de visión artificial
- Ingeniero de software
- Ingeniero en robótica
- Investigador cuantitativo
- Ingeniero de sistemas
Haga clic aquí para descargar la infografía.
Fuente de noticias
Empleos destacados
Cursos y herramientas en línea